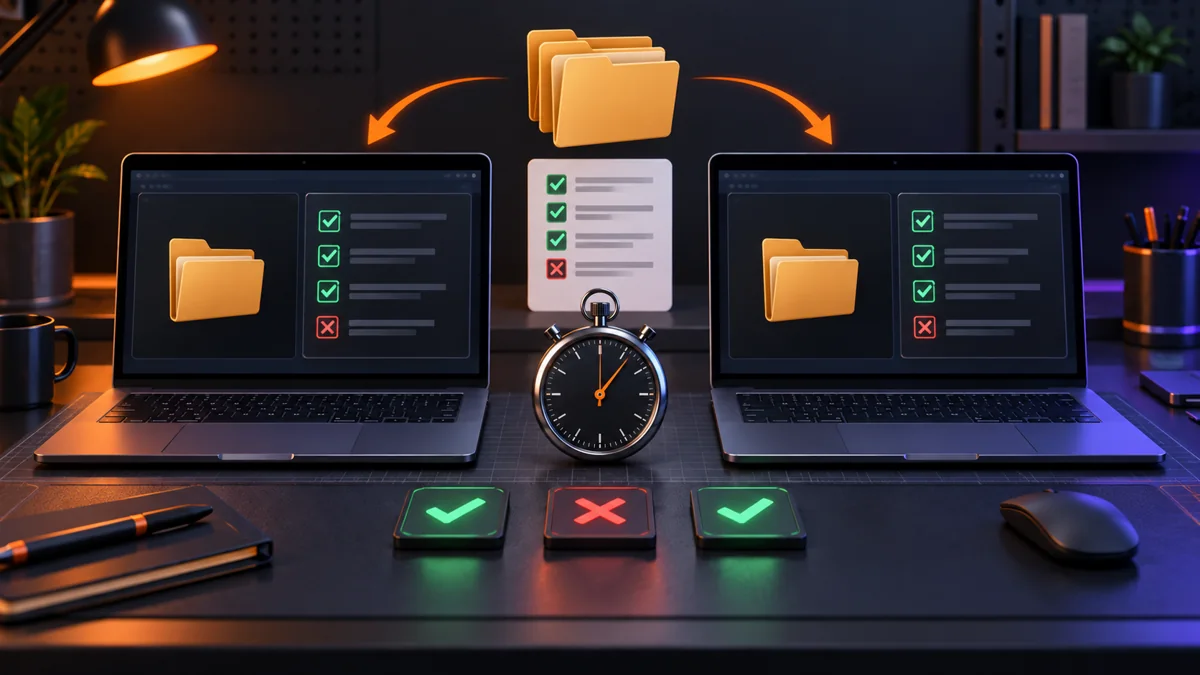
AI 코딩 도구 비교는 한 번의 체감 시간으로 결론내리면 안 된다. 같은 시작 파일, 같은 요청, 같은 실행 환경, 같은 권한, 같은 재시도 규칙을 고정한 뒤 검사를 통과한 실행의 시간을 비교해야 한다. 실패·중단·사람 개입은 평균 시간에서 빼고 별도 행으로 남긴다.
공개 Codex 이슈에는 한 도구가 5시간 넘게 걸리고도 버그를 고치지 못했지만 다른 도구는 1시간 안에 끝냈다는 자기보고가 있다. 두 실행의 시작 파일과 요청 전문, 권한, 모델, 완료 검사가 같은지는 공개되지 않았다. 이 사례는 브랜드 우열의 증거가 아니라 비교 조건 누락의 사례로만 사용한다.
목차
AI 코딩 도구 비교 전에 무엇을 같게 해야 하나?
먼저 아래 다섯 조건을 한 장에 적는다. 한 조건이라도 다르면 같은 작업의 속도 비교로 합치지 않는다.
| 고정할 것 | 기록할 값 | 다른 경우의 처리 |
|---|---|---|
| 시작 상태 | 공개 가능한 starter 폴더와 커밋 해시 | 같은 작업으로 합치지 않는다 |
| 요청 | 붙여 넣은 요청 전문과 완료 기준 | 표현을 바꾼 실행은 별도 행으로 둔다 |
| 실행 환경 | 운영체제, 도구 버전, 모델, 추론 강도 | 모르는 값은 미확인으로 남긴다 |
| 권한 | 파일 쓰기, 명령 실행, 네트워크 허용 범위 | 권한 차이를 성능 차이로 해석하지 않는다 |
| 재시도 | 최대 횟수와 사람이 개입하는 조건 | 추가 힌트와 재시도 횟수를 기록한다 |
시작 파일을 복사하는 시점부터 같아야 한다. 한쪽에는 이미 수정된 파일을 주고 다른 쪽에는 오류가 있는 원본을 주면 시간은 비교할 수 없다. 비밀키와 고객 데이터, 회사 저장소 대신 같은 실패를 담은 작은 공개용 fixture를 만든다.
도구가 완료했다고 말하면 성공인가?
아니다. 두 결과 폴더에서 같은 검사 명령을 실행하고 종료 코드와 출력을 보존해야 한다.
python3 check_result.py input.json tool-a/result.json
python3 check_result.py input.json tool-b/result.json
이번 글의 검사기는 ID 보존, 태그 중복 제거, 잘못된 행 보고라는 세 조건을 확인한다. 작성자가 만든 pass fixture는 세 조건을 통과해 exit 0을 냈다. fail fixture는 중복 태그와 누락된 오류 행을 찾아 exit 1을 냈다. 이 fixture는 검사기가 실패를 잡는지 확인하는 자료이며 실제 AI 도구의 결과가 아니다.
비개발자는 검사 파일을 어떻게 준비하나?
터미널을 열고 아래 명령으로 연습 폴더를 만든다. macOS와 Linux 기준이다. Windows에서는 파일 탐색기로 ai-tool-test 폴더를 만들고 그 폴더를 코드 편집기에서 연다.
mkdir ai-tool-test
cd ai-tool-test
메모장이나 코드 편집기에서 아래 내용을 input.json으로 저장한다. 1·2번 행은 정상이고 3번 행은 ID가 비어 있다. 정상 행의 태그에는 중복이 있다.
{"rows":[
  {"row":1,"id":"A-01","tags":["alpha","beta"]},
  {"row":2,"id":"B-02","tags":["beta","alpha"]},
  {"row":3,"id":"","tags":["gamma"]}
]}
두 도구에는 아래 요청을 한 글자도 바꾸지 않고 붙여 넣는다.
input.json을 읽어 ID가 있는 행만 처리하세요. 유효한 ID를 입력 순서대로 ids에 넣고, 유효한 행의 tags를 중복 없이 알파벳순으로 정리하세요. ID가 빈 행 번호는 invalid_rows에 넣으세요. 설명 없이 JSON만 result.json에 저장하세요. 출력 키는 ids, tags, invalid_rows입니다.
한쪽 결과는 tool-a.json, 다른 쪽 결과는 tool-b.json으로 보존한다. 도구가 result.json을 만들었다면 이름만 바꿔 복사한다.
아래 코드를 check_result.py로 저장한다. 검사기는 입력 파일에서 기대값을 다시 계산하므로 공개된 정답을 하드코딩하지 않는다.
import json, sys
from pathlib import Path

source = json.loads(Path(sys.argv[1]).read_text())
result = json.loads(Path(sys.argv[2]).read_text())
valid = [row for row in source["rows"] if row.get("id")]
expected_ids = [row["id"] for row in valid]
expected_tags = sorted({tag for row in valid for tag in row.get("tags", [])})
expected_invalid = [row["row"] for row in source["rows"] if not row.get("id")]
checks = {
    "keeps_input_ids": result.get("ids") == expected_ids,
    "deduplicates_tags": result.get("tags") == expected_tags,
    "reports_invalid_row": result.get("invalid_rows") == expected_invalid,
}
print(json.dumps({"checks": checks, "passed": all(checks.values())}, indent=2))
raise SystemExit(0 if all(checks.values()) else 1)
검사기 자체를 먼저 시험한다. 아래 파일을 result-pass.json으로 저장한다.
{"ids":["A-01","B-02"],"tags":["alpha","beta"],"invalid_rows":[3]}
아래 실패 예시는 result-fail.json으로 저장한다.
{"ids":["A-01","B-02"],"tags":["alpha","alpha","beta"],"invalid_rows":[]}
아래 두 명령을 실행한다. echo $?는 바로 앞 명령의 종료 코드를 보여 준다. pass는 "passed": true와 0, fail은 "passed": false와 1이 나와야 한다.
python3 check_result.py input.json result-pass.json; echo $?
python3 check_result.py input.json result-fail.json; echo $?
실제 비교에서는 도구 A와 B에 같은 입력 JSON과 “위 세 조건을 만족하는 결과 JSON을 만들어라”라는 같은 요청을 준다. 각 결과를 tool-a.json, tool-b.json으로 저장한 뒤 아래처럼 같은 검사기를 적용한다.
python3 check_result.py input.json tool-a.json; echo $?
python3 check_result.py input.json tool-b.json; echo $?
이 예시의 세 조건을 모든 코딩 작업에 그대로 쓰면 안 된다. 비교할 작업이 웹페이지라면 “필수 문구가 있는가”, CSV 정리라면 “행 수와 제외 목록이 맞는가”처럼 도구를 실행하기 전에 자신의 완료 조건으로 checks를 바꾼다. 검사 코드를 만들기 어렵다면 개발자에게 “입력 하나와 정답 하나로 자동 판정되는 검사 명령”을 먼저 요청한다.
시간과 실패는 어떻게 기록해야 하나?
통과 여부와 시간, 재시도, 사람 개입을 서로 다른 칸에 적는다. PASS 실행이 없으면 평균 속도를 만들지 않는다.
| 실행 | 검사 결과 | 벽시계 시간 | 재시도 | 사람 개입 | 판정 |
|---|---|---|---|---|---|
| 도구 A 1회차 | PASS / FAIL / 미실행 | 실제 값 | 실제 값 | 없음 또는 내용 | 완료 / 실패 / 중단 |
| 도구 B 1회차 | PASS / FAIL / 미실행 | 실제 값 | 실제 값 | 없음 또는 내용 | 완료 / 실패 / 중단 |
실패한 실행이 오래 걸렸다면 느린 성공으로 바꾸지 않는다. 실패와 소요 시간을 함께 적는다. 사람이 힌트를 추가했다면 도구가 혼자 처리한 실행과 분리한다.
로그인이나 한쪽 실행이 막히면 어떻게 판정하나?
인증, 사용량 한도, 계정 권한에서 막힌 실행은 미실행이다. 다른 쪽이 통과했더라도 그 한 번의 자료로 더 빠르거나 더 낫다고 결론내리지 않는다. 입력과 검사 명령을 보존하고 인증 복구 뒤 같은 조건으로 다시 실행한다.
브랜드별 역할부터 구분해야 한다면 Claude와 Claude Code의 역할 차이를 먼저 확인한다. 설치 단계에서 막혔다면 Claude Code 설치 오류 확인 순서로 문제를 분리한다. 설치 오류와 작업 결과를 한 점수로 섞으면 원인을 찾기 어렵다.
한 번 이긴 도구를 계속 선택해도 되나?
한 번의 실행은 그 starter와 요청에서 나온 결과다. 저장소 크기와 언어, 도구 버전, 모델이 바뀌면 결과도 달라질 수 있다. 공개 가능한 결론은 “이 조건에서 이 검사를 통과했고 몇 분이 걸렸다”까지다.
먼저 공개 가능한 작은 작업 하나를 고른다. 다섯 조건과 검사 명령을 한 파일에 적고, 두 도구를 실행하기 전에 검사기가 pass와 fail fixture를 구분하는지 확인한다. 그러면 답변의 자신감보다 결과를 기준으로 비교할 수 있다.
검증 기준
- 마지막 업데이트일: 2026-09-18
- 확인 환경: macOS 로컬 Python 3 검사기에서 작성자 fixture 두 개를 실행했다. pass는 exit 0, fail은 exit 1이었다.
- 주요 근거: OpenAI Codex 공개 이슈, Codex bug triage skill
- 검색 확인: 2026-09-18 Google·Naver에서
AI 코딩 도구 비교를 조회했다. 상위 결과는 추천·순위·가격·특징 목록형이 중심이었다. Google 관련 표현AI 코딩 성능 비교는 관측했지만 추천 노출을 검색량으로 해석하지 않았다. - 미확인: 정확 월간 검색량, 직접 독자 응답, 브랜드별 동일 조건의 실제 실행 결과
직접 만든 실습 자료와 새 도구 소식
AI 도구로 만든 실습 자료, 달라진 기능과 강의 소식을 준비하고 있습니다. 발송을 시작하면 안내해 드려요. 먼저 확인 메일에서 본인 이메일을 확인해 주세요.
신청하기 전에 첫 소식 미리보기에서 내용과 자료를 확인해 보세요.